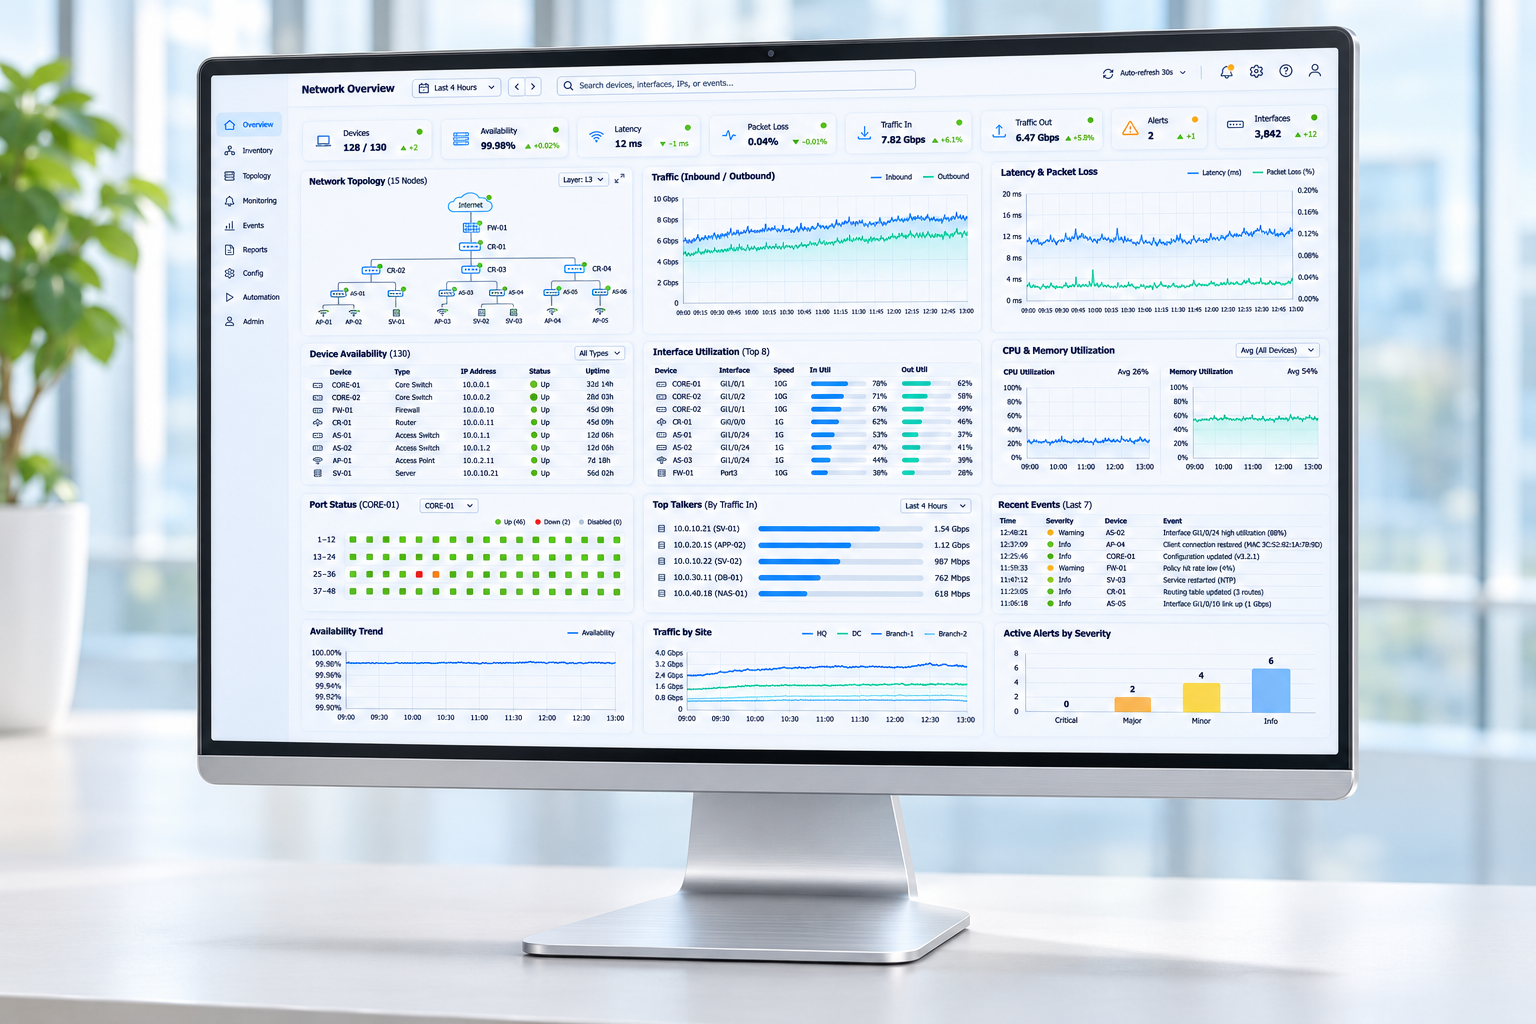
사내 시스템이 느려졌을 때 운영자에게 필요한 것은 장애 알림만이 아니라, 어디에서 무엇이 달라졌는지 살펴볼 근거입니다. 이 글은 NMS를 처음 살펴보거나 도입·운영 범위를 정하려는 담당자를 위해 주요 모니터링 대상과 지표, FCAPS의 관리 영역, 수집 방식과 해석 시 주의점을 설명합니다. 작은 환경에서 관리 우선순위를 정하는 방법과 오픈소스·상용, 구축형·SaaS형을 비교할 기준도 짚습니다. 이를 통해 장애 조사에 필요한 정보를 구분하고, 우리 조직의 인력·비용·지원 여건에 맞는 모니터링과 운영 방식을 구체화할 수 있습니다. |
회사에 출근해 PC 전원을 켜고, 메일을 확인합니다. 사내 시스템에서 업무 자료를 내려받고, 잠시 후에는 동료들과 화상회의에 접속합니다. 매일 반복하는 익숙한 일이지만, 그 뒤에서는 여러 네트워크 장비와 연결 구간이 데이터를 주고받고 있습니다.
그런데 어느 날 사내 시스템이 유난히 느리게 열리고, 화상회의 중 목소리가 끊긴다면 어떨까요? 내 PC만의 문제인지, 사무실의 연결 상태가 불안정한지, 접속한 서비스에 문제가 생긴 것인지 화면만 봐서는 알기 어렵습니다. 이때 네트워크의 상태와 변화 이력을 확인할 근거가 필요합니다.
이 글에서는 이런 내용을 다뤄요
• NMS가 필요한 이유와 주요 모니터링 대상·지표
• FCAPS 5대 관리 기능과 장애 조사에서의 활용
• 주요 수집 방식의 특징과 데이터 해석 시 주의점
• 운영 여건에 맞는 도입 방식과 통합 관리·옵저버빌리티·AIOps 연계
이런 분들께 도움이 돼요
• NMS의 기본 개념과 주요 기능을 처음 익히는 분
• 장애나 속도 저하의 원인을 조사하는 네트워크·IT 운영 담당자
• 제한된 인력과 예산으로 NMS 도입·운영 범위를 정하려는 분
NMS는 무엇이고, 왜 필요한가?
NMS(Network Management System, 네트워크 관리 시스템)는 기업이나 조직의 네트워크 장비와 연결 상태를 중앙에서 모니터링하고 관리하는 시스템입니다. 장비의 응답 여부와 자원 상태, 인터페이스의 트래픽 등을 수집해 운영자가 현재 상태를 확인하고 이상 징후에 대응하도록 돕습니다. 제품과 구성에 따라 구성 정보 관리, 설정 변경 이력, 이벤트 분석 등의 기능도 제공할 수 있습니다. [1, 2]
NMS가 필요한 이유는 장비를 한 화면에 표시하기 위해서만은 아닙니다. 장애 신고를 받은 뒤 장비에 하나씩 접속하면 문제가 지나간 시점의 상태를 놓치기 쉽습니다. NMS로 관련 장비와 구간의 지표를 같은 시간대에 비교하면 어디부터 조사할지 범위를 좁힐 수 있고, 축적한 이력은 반복 장애 분석과 회선 증설 판단에도 활용할 수 있습니다. 다만 탐지 속도는 수집 간격과 이벤트 전달 방식에 따라 달라지므로, ‘실시간 모니터링’이라는 표현이 모든 변화를 지연 없이 확인한다는 뜻은 아닙니다.
이러한 관리가 필요한지는 장비 수보다 업무의 의존도를 기준으로 판단하는 편이 좋습니다. 서버가 수십 대인 환경이라도 지점 간 연결이나 핵심 업무가 하나의 회선에 의존한다면, 해당 구간의 장애는 곧 업무 중단으로 이어질 수 있습니다. 특히 사용자의 불편 신고가 들어와야 문제를 알게 되는 상황이라면 상태와 이력을 먼저 확보할 필요가 있습니다. 다만 이미 사용하는 도구로 필요한 상태 확인과 알림이 가능하다면, 별도 NMS를 추가하기 전에 기존 기능의 활용 범위부터 점검할 수 있습니다.
처음부터 모든 장비와 지표를 관리할 필요는 없습니다. 업무에 중요한 스위치·라우터·방화벽과 핵심 회선을 먼저 선정하고, 담당자가 확인하고 대응할 수 있는 수준으로 시작하는 것이 현실적입니다. 이후 반복되는 문제와 관리 대상의 변화에 맞춰 범위를 넓혀 가면 됩니다. 이때 어떤 대상에서 무엇을 관찰해야 하는지가 다음 판단 기준이 됩니다.
주요 모니터링 대상
네트워크 모니터링의 대상은 라우터나 스위치 같은 장비에 그치지 않습니다. 장비 사이의 연결 구간과 트래픽, 안정적인 동작에 필요한 물리적 상태까지 함께 확인해야 합니다. 실제 수집 항목은 장비가 제공하는 정보와 솔루션의 지원 범위에 따라 달라집니다.
대상 | 주요 확인 항목 | 운영에서 확인할 점 |
네트워크 장비 | 라우터·스위치·방화벽의 응답 여부, CPU·메모리, 인터페이스 상태 | 장비 전체가 정상이어도 특정 포트에서 문제가 생길 수 있습니다. 장비와 인터페이스를 나누어 확인합니다. |
링크 및 트래픽 | 회선·인터페이스별 송수신량과 사용률, 오류·폐기, 지연·손실, 통신 흐름 | 사용량이 몰린 구간과 품질 저하가 나타난 시점을 비교합니다. 흐름 분석은 지원 장비와 수집·분석 기능이 필요합니다. |
물리적 환경 | 장비 온도, 전원·팬 상태 등 지원되는 센서 정보 | 온도 상승이나 전원 이상이 성능 변화와 겹치는지 확인합니다. 센서 미지원이나 수집 누락을 정상으로 해석하지 않습니다. |
관찰할 지표는 연결 상태, 용량, 전달 오류, 통신 품질이라는 네 관점으로 묶어 볼 수 있습니다. 가용성과 도달성으로 연결이 유지되는지 확인하고, 트래픽과 사용률로 여유 용량을 살핍니다. 여기에 오류·폐기와 지연·손실·지터를 함께 보면 장비가 켜져 있어도 업무가 원활하지 않은 상황을 구분하는 데 도움이 됩니다.
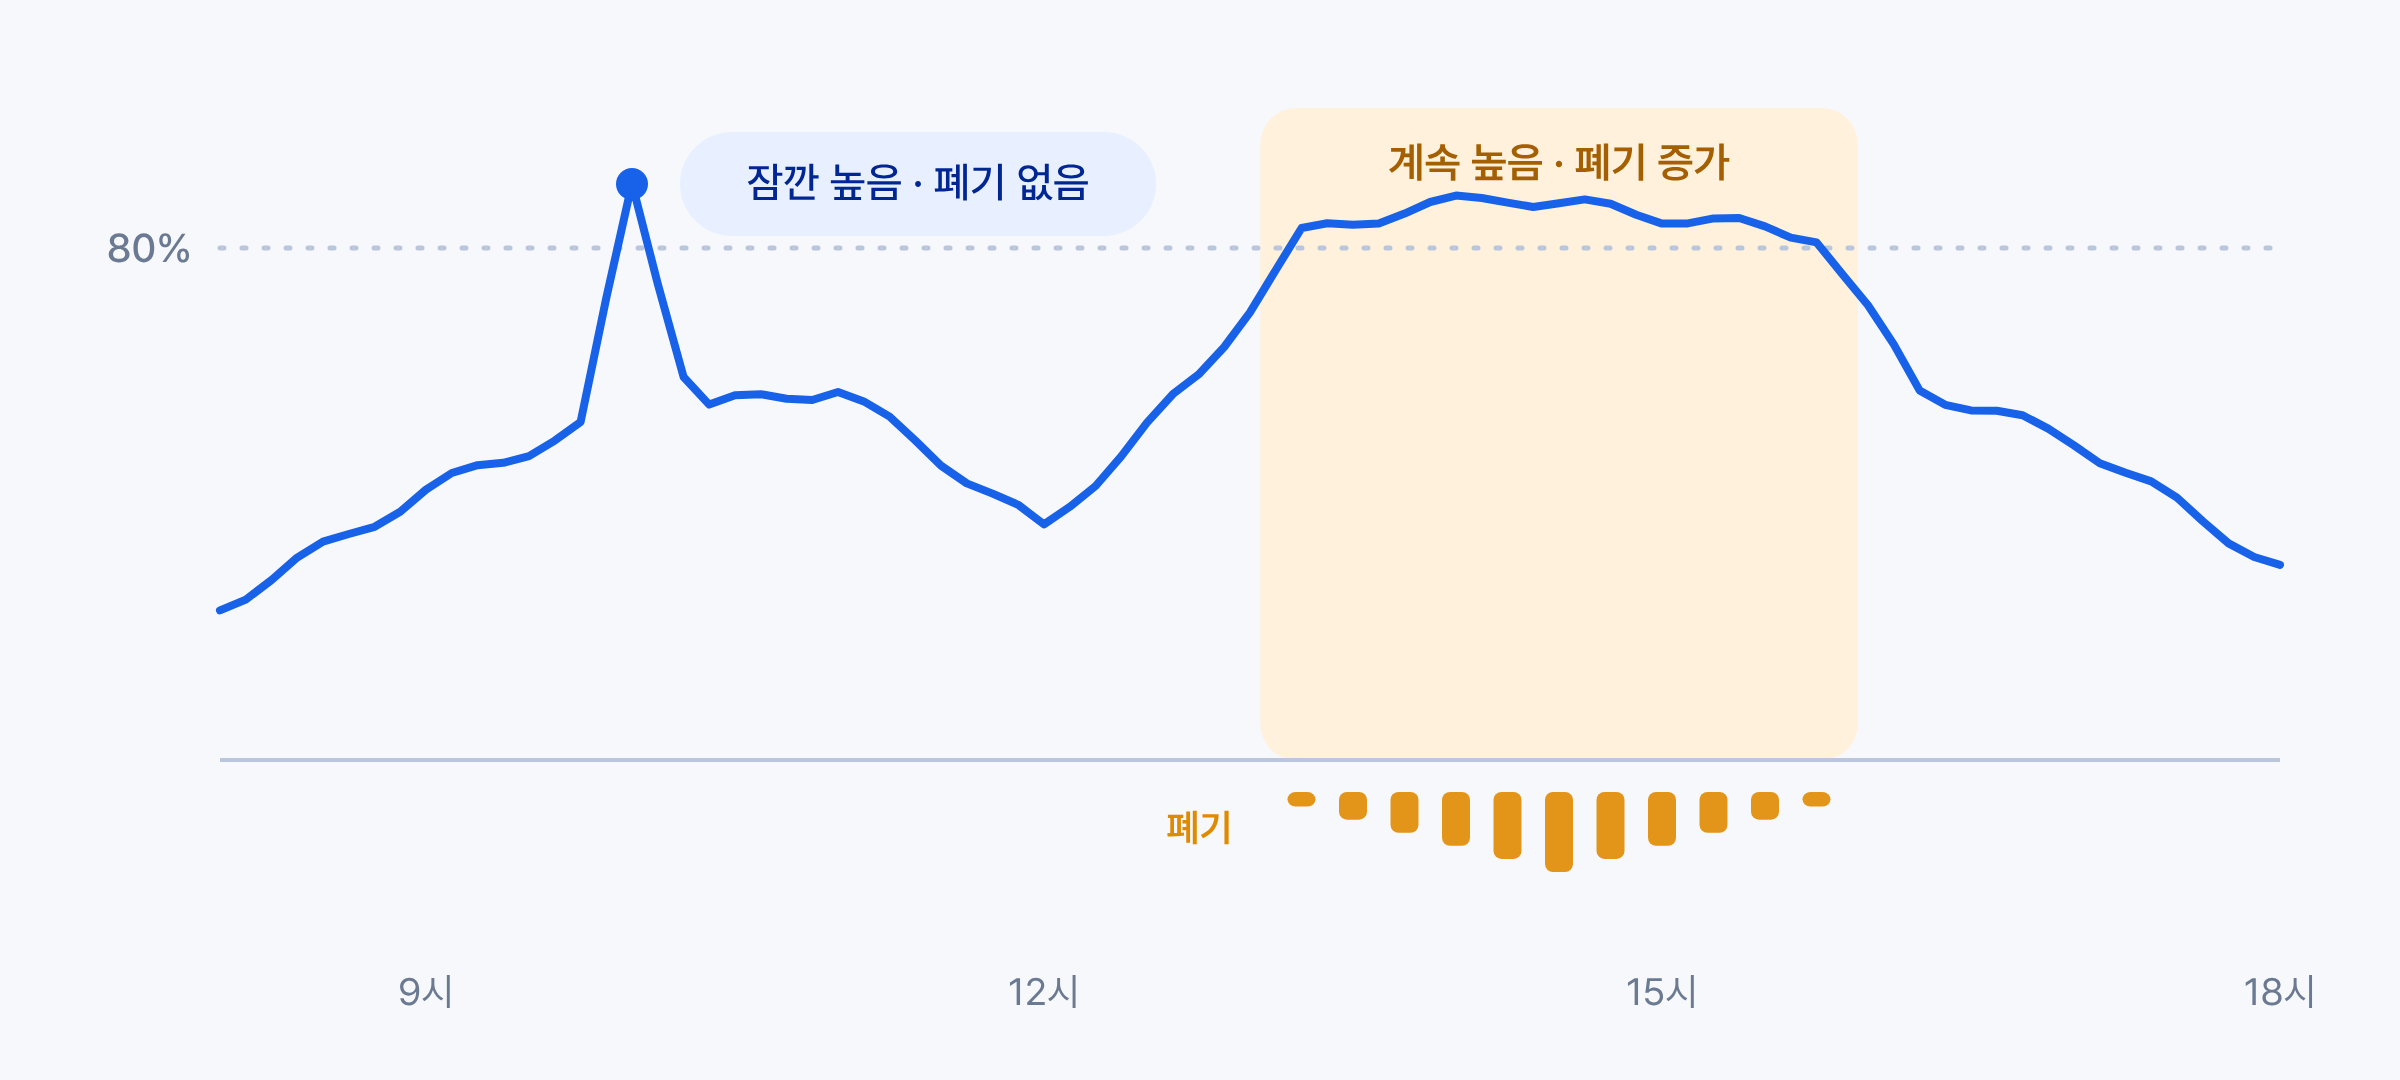
예를 들어 100Mbps를 기준으로 하는 회선에서 수신 전송률이 80Mbps라면 수신 방향 사용률은 80%입니다. 그러나 이 수치만으로 장애나 증설 필요성을 판단할 수는 없습니다. 높은 상태가 얼마나 지속되는지, 평소 같은 시간대와 다른지, 폐기나 지연이 함께 늘었는지를 확인해야 합니다. 전이중 링크에서는 송신과 수신 방향을 구분하고, 장비 포트 속도와 실제 회선 용량 중 무엇을 기준으로 계산했는지도 살펴야 합니다. [3, 4]
핵심 기능 FCAPS 5대 관리
FCAPS는 네트워크 관리 업무를 장애, 구성, 사용량·과금, 성능, 보안의 다섯 영역으로 나눈 틀입니다. NMS가 어떤 운영 문제를 지원하는지 이해하고 필요한 기능을 검토하는 데 유용합니다. 다만 FCAPS가 모든 NMS 제품에 동일하게 구현되는 것은 아니므로, 실제 제공 기능과 연동 범위는 별도로 확인해야 합니다. [1]
관리 영역 | 주요 역할 | 운영 활용 예 |
F 장애 관리 | 장애 징후 탐지, 이벤트 기록과 담당자 통지, 조사·복구 지원 | 여러 장비에서 경보가 발생하면 연결 관계와 발생 시각을 비교해 먼저 점검할 구간을 좁힙니다. |
C 구성 관리 | 장비 목록, 연결 구성, 설정과 변경 이력 관리 | 장애 발생 전후에 장비·회선·설정이 바뀌었는지 확인하고 실제 구성과 관리 정보를 맞춥니다. |
A 사용량·과금 관리 | 자원 사용량을 집계해 비용 배분이나 과금의 근거 제공 | 부서·지점·서비스별 사용량을 분석해 자원 배분과 비용 검토에 활용합니다. |
P 성능 관리 | 트래픽, 지연, 오류·폐기, 가용성 등의 측정과 추세 분석 | 반복되는 사용량 증가와 업무 응답 저하를 비교하고 용량 계획이나 운영 조정의 근거를 마련합니다. |
S 보안 관리 | 관리 접근 권한과 인증 등 네트워크 자원의 안전한 운영 지원 | 허용된 관리자만 장비에 접근하도록 관리하고, 제품·연동 범위에 따라 관련 보안 이벤트를 확인합니다. |
Accounting은 ‘계정 관리’로 번역되기도 하지만, 여기서는 로그인 계정이나 사용자 권한보다 네트워크 자원 사용량과 비용 배분을 다루는 의미입니다. 접근 권한과 인증은 보안 관리 영역으로 구분하면 혼동을 줄일 수 있습니다. 또한 보안 관리 기능이 있다는 이유만으로 NMS가 방화벽이나 SIEM의 모든 기능을 대신한다고 보아서는 안 됩니다.
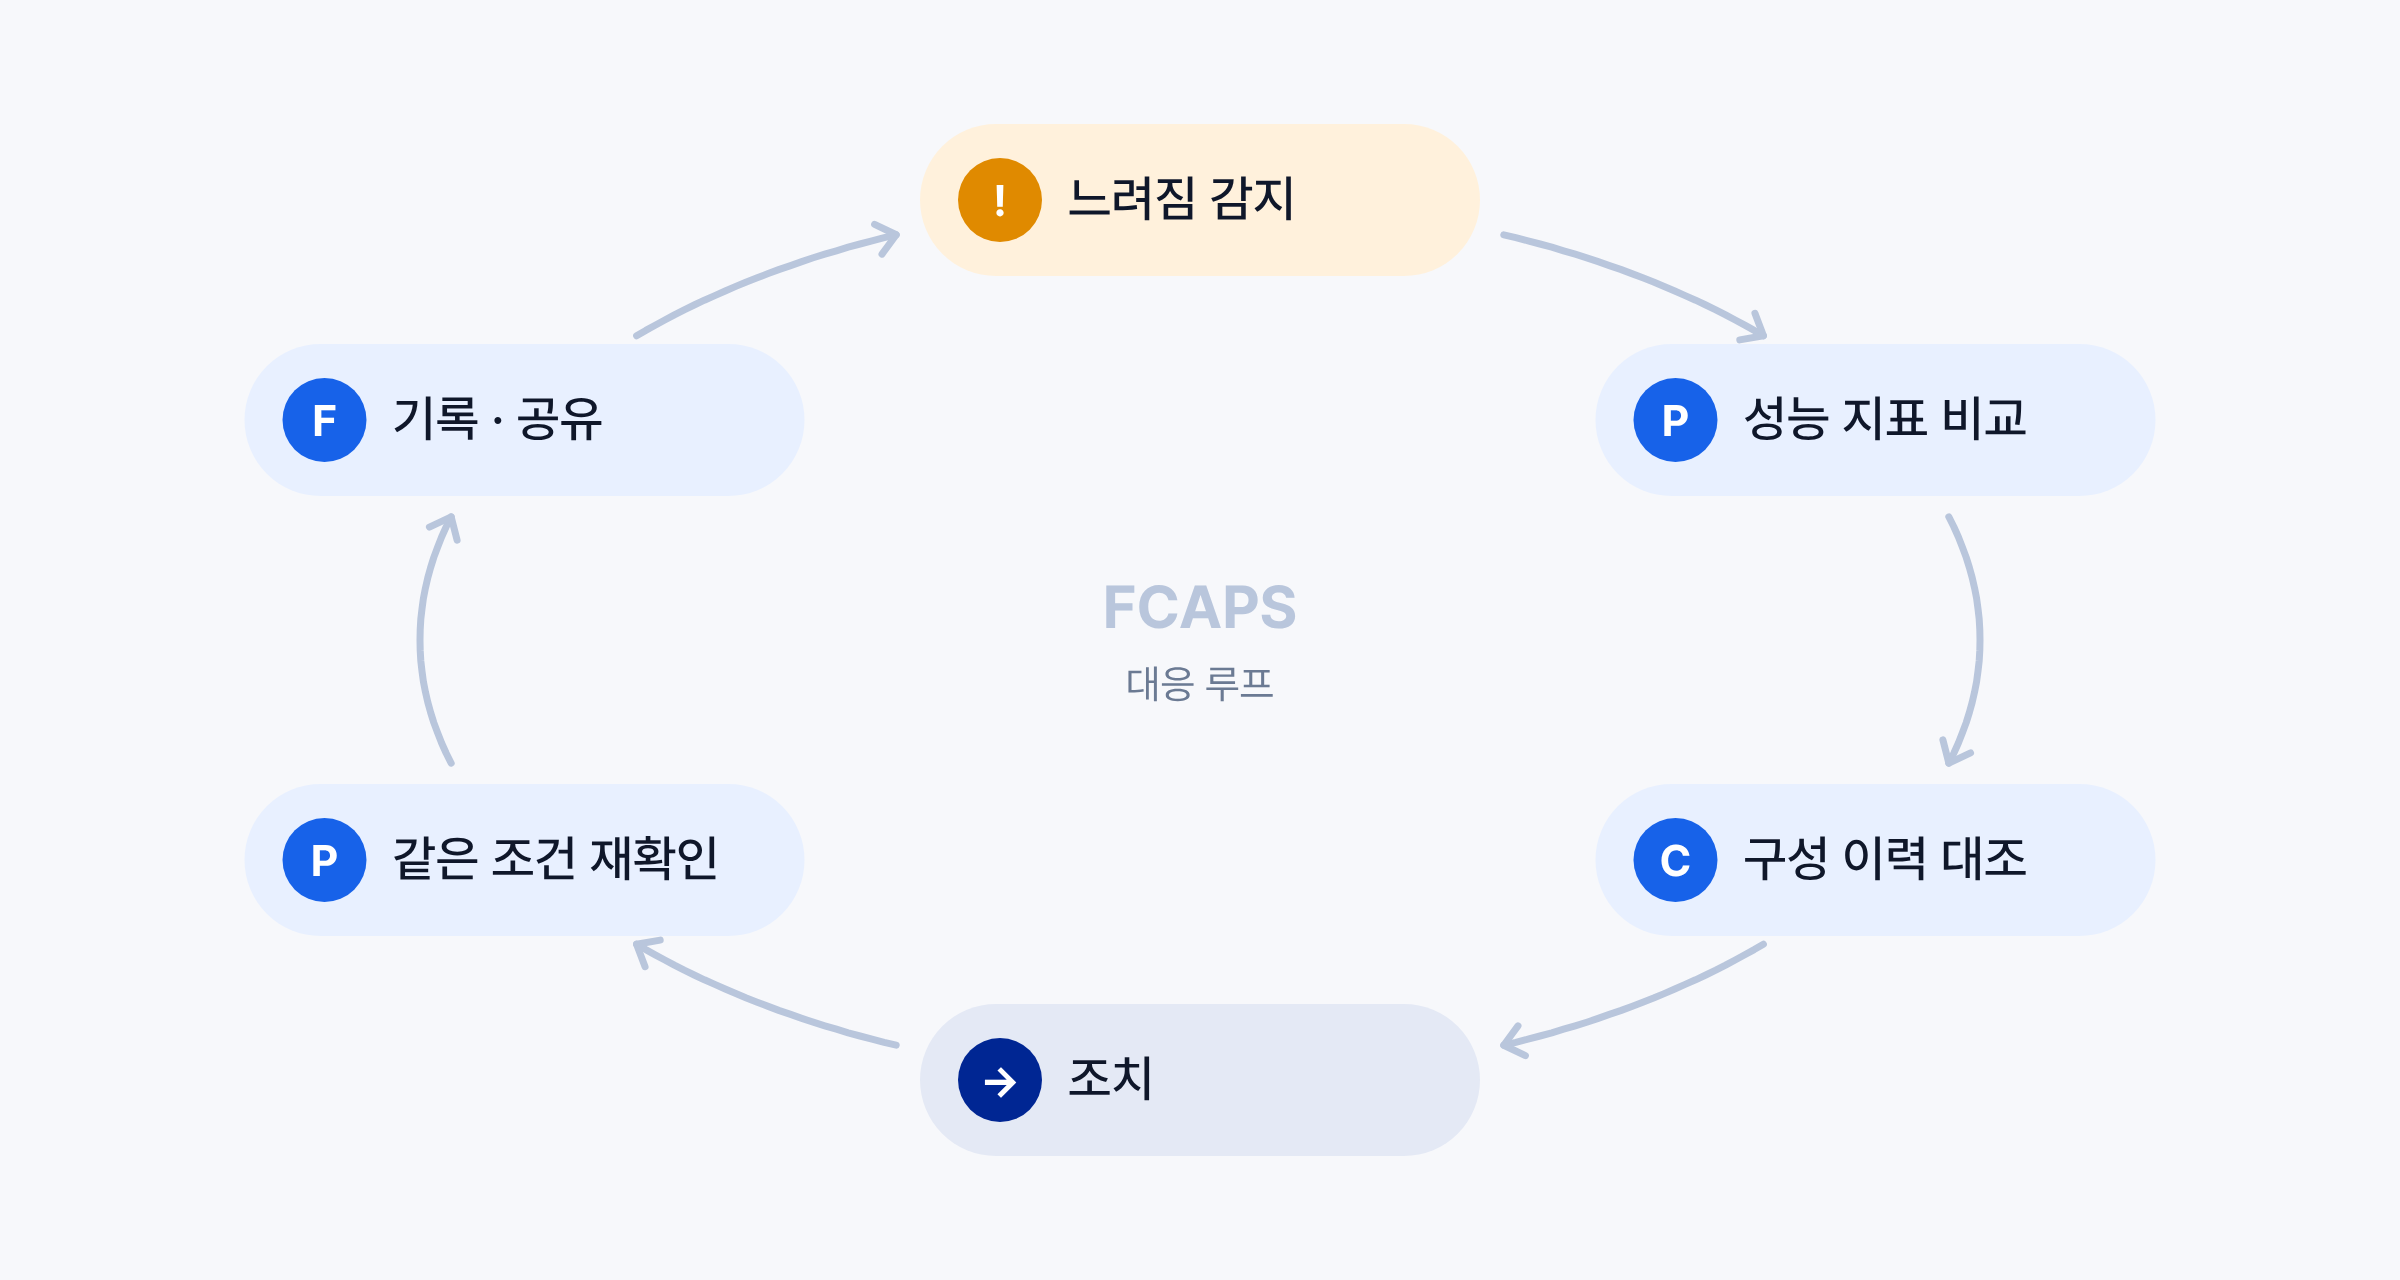
운영에서는 다섯 영역이 서로 연결됩니다. 매일 오전 지점의 자료 다운로드가 느려진다면 성능 지표로 문제 구간을 찾고, 구성 변경이나 정기 작업 이력을 대조할 수 있습니다. 혼잡 가능성이 확인되면 관련 담당자와 작업 시간 조정 등을 검토하고, 조치 뒤 같은 시간대의 지표와 업무 응답을 다시 확인합니다. 이 과정이 이어져야 수집한 데이터가 원인 조사와 재발 방지에 활용됩니다.
주요 수집 프로토콜
수집 방식마다 확인할 수 있는 정보가 다르기 때문에 한 가지 방법만으로 네트워크 상태를 모두 판단하기는 어렵습니다. 도달성을 시험하는 ICMP, 관리 항목을 조회하는 SNMP, 트래픽의 구성을 살피는 흐름·샘플 정보 등을 목적에 맞게 조합합니다. [8]
수집 방식 | 확인할 수 있는 정보 | 해석 시 주의할 점 |
SNMP | 주기적인 조회로 인터페이스 상태·송수신량과 장비가 지원하는 자원 지표 수집 | 폴링 간격 사이의 짧은 변화는 가려질 수 있습니다. 간격과 장비 수, 수집 부하를 함께 고려합니다. |
ICMP와 Ping | 관측 지점에서 대상까지의 응답 여부, 왕복시간, 응답 누락 정도 | 무응답은 장비 장애 외에 차단·제한이나 경로 문제 때문일 수 있습니다. 응답 성공이 로그인 등 업무 기능의 정상을 보장하지는 않습니다. |
NetFlow·IPFIX | 출발지·목적지 등 통신 흐름별 사용량과 특성 | 지원 장비와 수집·분석 기능이 필요합니다. 샘플링 여부와 수집 조건에 따라 분석 범위가 달라집니다. |
sFlow | 패킷 샘플과 인터페이스 카운터 등을 활용한 트래픽 관찰 | 모든 패킷 내용을 저장하는 방식이 아닙니다. 샘플 정보를 전체 통신의 완전한 기록으로 해석하지 않습니다. |
SNMP에서 관리 항목의 의미와 형식은 MIB(Management Information Base)에 정의되며, 항목은 OID(Object Identifier)라는 식별자로 구분됩니다. 표준 항목 외에 제조사별 항목도 있으므로 필요한 지표를 실제로 수집할 수 있는지 확인해야 합니다. 수집 환경에서는 읽기 권한과 접근 허용 범위, SNMPv3의 인증·암호화 설정도 함께 점검합니다. [5]
폴링을 보완하는 방식으로 SNMP Trap과 Syslog도 사용합니다. Trap은 장비가 사건이나 상태 변화에 대해 보내는 통지이고, Syslog는 장비·시스템의 이벤트 로그를 전달하는 데 활용됩니다. 수집된 정보를 운영자에게 알릴 때는 발생·복구 조건, 지속 시간, 중요도와 담당자를 정해야 합니다. 관리 시스템이 메시지를 받는 것과 담당자가 조치할 경보를 받는 것은 별개의 단계이기 때문입니다. [1, 6]
운영 여건에 맞는 도입 방식 선택하기
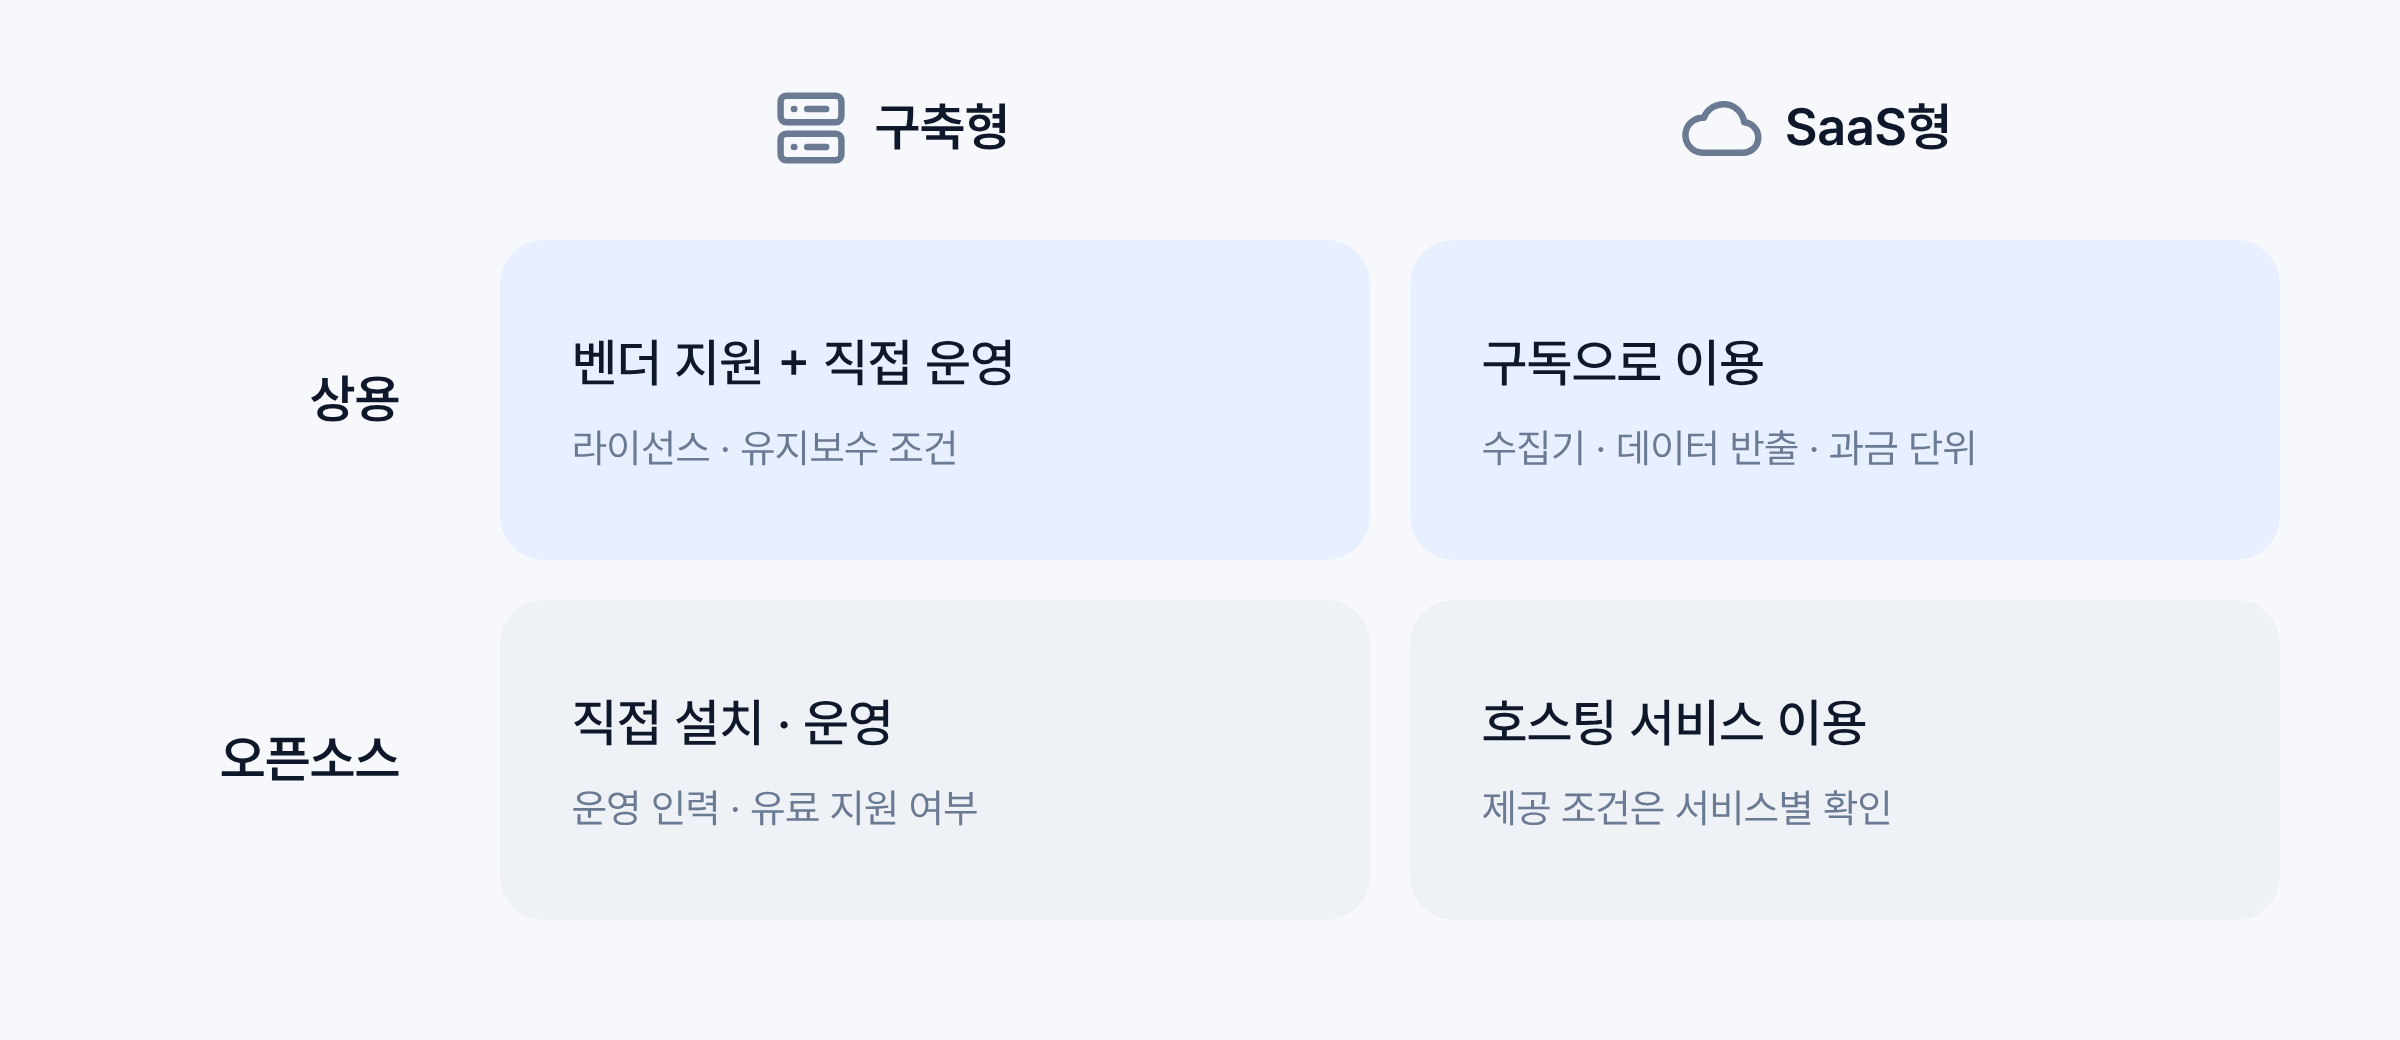
NMS의 도입 방식을 이해하려면 두 가지 기준을 구분해야 합니다. 소프트웨어의 라이선스와 지원 체계를 기준으로는 오픈소스와 상용 제품을, 제공·운영 형태를 기준으로는 직접 설치해 운영하는 구축형과 서비스로 이용하는 SaaS형을 살펴볼 수 있습니다. 오픈소스를 직접 구축할 수도 있고, 상용 제품을 구축형이나 SaaS형으로 이용할 수도 있습니다. 즉 라이선스와 운영 형태를 조합해 우리 조직에 맞는 방식을 선택할 수 있습니다. 먼저 필요한 운영 형태를 정한 뒤, 그 안에서 제품과 지원 조건을 비교하는 것이 좋습니다.
이러한 선택에서 중요한 것은 비용뿐 아니라 관리 체계를 유지할 역량입니다. 오픈소스는 라이선스 비용 부담을 낮출 수 있지만, 장비를 연동하고 알림 기준을 조정하며 업데이트하는 업무까지 없어지는 것은 아닙니다. 반대로 상용 제품도 도입비만으로 운영이 끝나는 것은 아니므로, 유지보수와 추가 기능에 필요한 비용을 함께 검토해야 합니다.
따라서 비용 비교는 동일한 관리 대상과 데이터 보관 기간, 필요한 가용성 수준을 놓고 진행해야 합니다. 구축비에 운영 인력의 투입 시간, 기술지원, 향후 확장 비용을 더한 총소유비용(TCO)을 계산하면 선택의 근거가 분명해집니다. 자체 설정과 확장을 담당할 역량이 충분한 조직은 오픈소스의 유연성을 활용할 수 있고, 장비 연동이나 장애 대응에서 외부 지원이 필요한 조직은 상용 제품과 유료 지원 서비스를 함께 검토할 수 있습니다.
지원 체계 역시 제품의 유료·무료 구분만으로 판단하기는 어렵습니다. 오픈소스에도 유료 기술지원과 응답시간 약정을 제공하는 경우가 있기 때문입니다. 계약에서는 야간을 포함한 지원 시간과 최초 응답 조건, 실제 지원 범위를 확인해야 합니다. 운영 인원이 몇 명인지보다 내부에서 맡을 수 있는 일과 외부에 맡겨야 할 일을 구분하는 것이 중요합니다. [7]
구축형과 SaaS형을 비교할 때도 같은 원칙이 적용됩니다. SaaS가 관리 서버의 설치와 유지 부담을 줄여 줄 수는 있지만, 장비·인터페이스·수집량·보관 기간 등 과금 기준은 제품마다 다릅니다. 현장 수집기가 필요한지, 외부 연결과 데이터 반출이 허용되는지도 함께 확인해야 합니다. 작은 인프라라고 해서 어느 한 방식이 반드시 저렴한 것은 아니며, 필요한 기능을 꾸준히 운영할 수 있는 조건인지가 선택의 기준입니다.
복잡해지는 인프라에서 더 중요해지는 네트워크 관리
디지털 인프라가 온프레미스와 클라우드, 여러 지점으로 확장되면서 운영자가 살펴야 할 대상과 연결 관계도 복잡해지고 있습니다. 이제는 개별 장비가 정상인지 확인하는 데서 나아가, 네트워크의 변화가 어떤 서비스와 업무에 영향을 주는지 파악해야 합니다. 이에 따라 네트워크를 관리하는 NMS의 정보와 서버·데이터베이스 등 다른 영역의 정보를 함께 살피는 인프라 통합 관리로 범위를 넓힐 수 있습니다. 국내 IT 운영 관리 분야에서는 이를 EMS(Enterprise Management System)라고 부릅니다. [10]
이러한 흐름 속에서 옵저버빌리티(Observability, 관측 가능성)와 AIOps도 함께 주목받고 있습니다. 옵저버빌리티는 지표·로그·트레이스 등 다양한 데이터를 연결해 시스템의 동작과 내부 상태를 이해하는 데 초점을 둡니다. AIOps는 AI와 머신러닝을 활용해 이상 징후나 이벤트의 연관성을 분석하고, 운영자의 판단과 대응을 지원하는 접근입니다. 다만 NMS에서 EMS를 거쳐 이 기술들로 반드시 교체해야 한다는 뜻은 아닙니다. 관리 대상과 목적에 따라 기존 모니터링을 보완하고 서로 연계해 활용할 수 있습니다. [10, 11]
관리 기술이 발전할수록 중요한 것은 더 많은 데이터를 모으는 일 자체가 아니라, 신뢰할 수 있는 데이터로 서비스의 상태를 설명하고 조치의 우선순위를 정하는 일입니다. NMS에서 장비와 회선의 상태를 정확히 수집하고 연결 관계와 변화 이력을 관리하는 작업은 그 출발점이 됩니다. 우리 환경에 필요한 지표와 수집 방식을 정하고, 이를 담당자의 확인과 조치로 이어 갈 때 네트워크 모니터링은 장애를 알리는 도구를 넘어 안정적인 서비스 운영을 위한 판단 근거가 될 수 있습니다.
참고 자료
[1] Cisco Network Management System Best Practices
https://www.cisco.com/c/en/us/support/docs/availability/high-availability/15114-NMS-bestpractice.html
[2] 엔키아 NMS
https://nkia.co.kr/solutions/it%EC%9A%B4%EC%98%81%EA%B4%80%EB%A6%AC/nms
[3] RFC 2863 The Interfaces Group MIB
https://www.rfc-editor.org/rfc/rfc2863.html
[4] Cisco How To Calculate Bandwidth Utilization Using SNMP
https://www.cisco.com/c/en/us/support/docs/ip/simple-network-management-protocol-snmp/8141-calculate-bandwidth-snmp.html
[5] RFC 3410 Internet Standard Management Framework
https://www.rfc-editor.org/rfc/rfc3410.html
[6] RFC 5424 The Syslog Protocol
https://www.rfc-editor.org/rfc/rfc5424.html
[7] Zabbix Technical Support and Subscriptions
https://www.zabbix.com/subscriptions
[8] sFlow Overview
https://sflow.org/sFlowOverview.pdf
[9] IBM What is network observability
https://www.ibm.com/think/topics/network-observability
[10] IBM What is AIOps
https://www.ibm.com/think/topics/aiops